Tenir un agent de code IA : cadrer avant, vérifier après
Deux moments pour garder la main sur un agent qui code : la laisse courte avant qu'il agisse, le sifflet après. Et ce que valent vraiment les tests écrits par l'IA.
- Agents de code
- Agents IA
- Qualité logicielle
- Tests
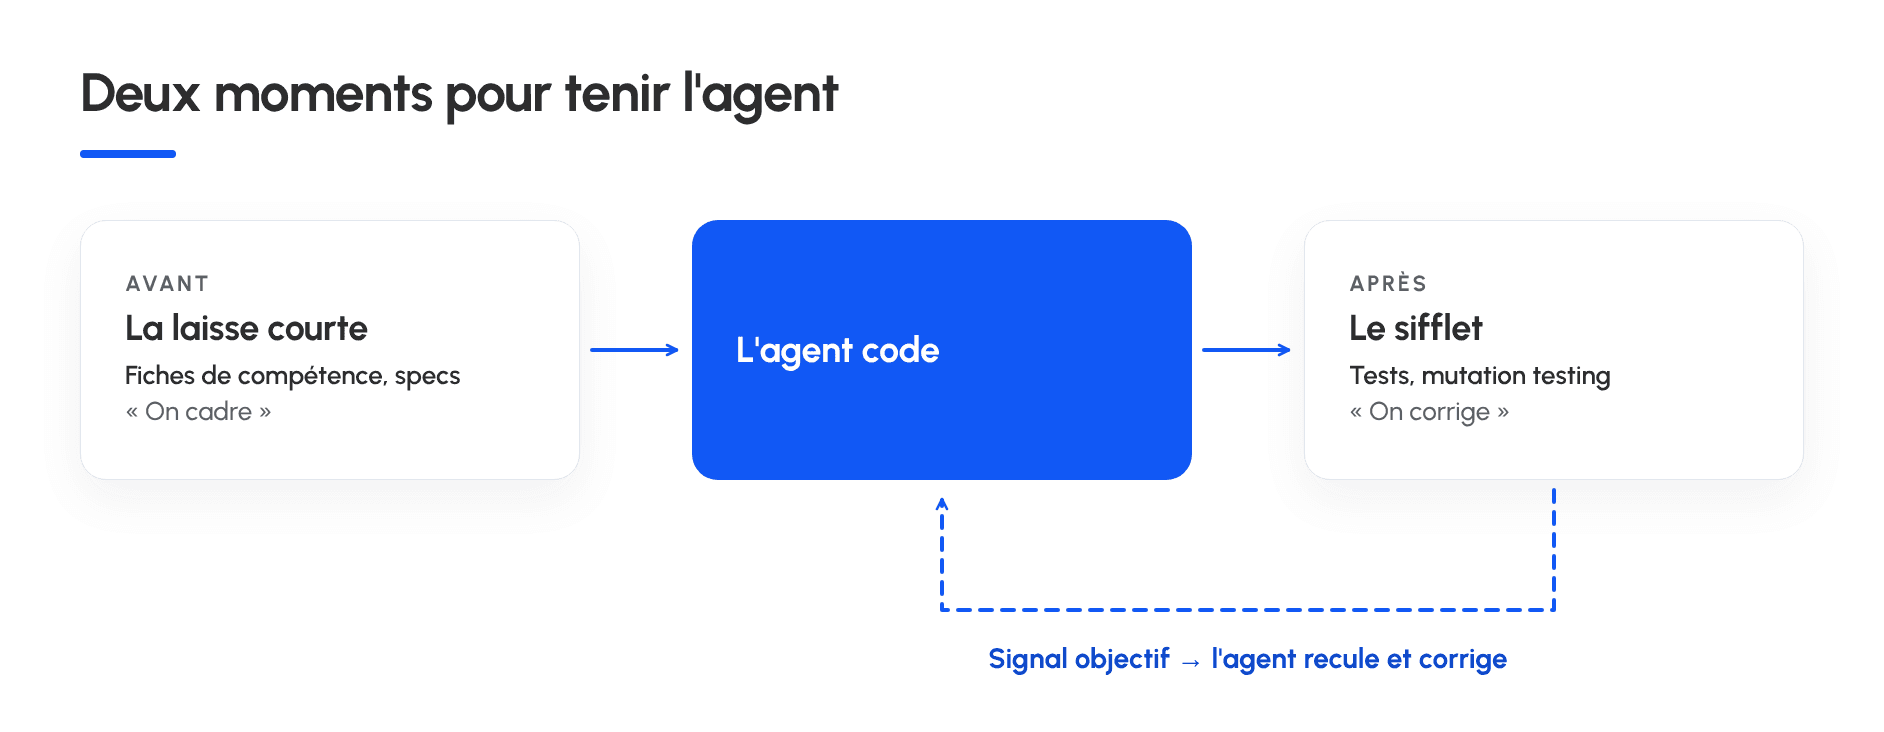
En bref. Pour garder la main sur un agent de code IA, on agit à deux moments : avant qu’il agisse, on le cadre (feedforward) avec des fiches de compétence et un cahier des charges ; après, on le fait se corriger (feedback) avec des capteurs comme les tests. Les fiches de compétence économisent sa mémoire de travail, mais celles trouvées sur internet peuvent être piégées. Le mutation testing est le capteur clé, car il vérifie que les tests écrits par l’IA testent vraiment quelque chose. Et un capteur ne vaut que s’il est objectif : l’IA qui se relit elle-même ne suffit pas.
Sans prérequis technique. Le texte principal se lit de bout en bout sans bagage particulier ; les encadrés « Pour aller plus loin » ajoutent le vocabulaire précis pour qui veut creuser.
Imaginez que vous promenez un chien jeune et fougueux. Il est vif, rapide, plein de bonne volonté ; lâché sans rien, pourtant, il file droit dans les massifs. Pour le tenir, vous avez deux gestes, et deux seulement.
- Avant qu’il parte, vous tenez la laisse courte : vous cadrez sa trajectoire pour qu’il aille au bon endroit du premier coup.
- Après qu’il s’est élancé, vous avez le sifflet : un rappel qui le fait revenir et corriger sa course quand il dévie.
Une IA qui code ressemble à ce chien fougueux. Les experts appellent ces deux gestes feedforward (cadrer avant) et feedback (corriger après). Ce sont les deux mains d’un même harnais, et il faut les deux : lâcher l’une, c’est ne plus tenir l’agent. Le chien, la laisse et le sifflet sont des images pédagogiques, absentes des sources.
Comment garder le contrôle d’un agent de code IA ?
En agissant à deux moments : avant que l’agent agisse, pour qu’il réussisse du premier coup, et après, pour qu’il repère et corrige seul ses erreurs. Tout le contrôle d’une IA qui code se range dans l’une de ces deux familles, selon le moment où il intervient.
| Avant (la laisse courte) | Après (le sifflet) | |
|---|---|---|
| Quand | Avant que l’agent agisse | Après qu’il a agi |
| À quoi ça sert | Cadrer pour qu’il réussisse du premier coup | Le faire reculer et se corriger tout seul |
| Les outils | Fiches de compétence, cahier des charges | Tests, mutation testing, relecture |
| Si on l’oublie | L’agent improvise et part de travers | L’agent répète ses erreurs sans jamais le savoir |
Pour aller plus loin : feedforward et feedback En vocabulaire technique, cadrer avant relève du feedforward, corriger après du feedback. Le Technology Radar Vol. 34 de Thoughtworks (avril 2026) décline ainsi le couple guides et sensors formalisé par Birgitta Böckeler : les guides anticipent avant l’action, les capteurs observent après, pour que l’agent se corrige avant même qu’un humain ne relise. C’est la réponse concrète au mot d’ordre du Radar : putting coding agents on a leash, mettre les agents de code en laisse.
Que sont les Agent Skills, ces fiches de compétence pour agents IA ?
Des fiches qui décrivent chacune une procédure (écrire un test dans ce projet, déployer, respecter les conventions), rangées dans un classeur que l’agent consulte seulement quand une fiche correspond à sa tâche du moment. C’est l’un des outils les plus en vue pour cadrer un agent avant qu’il agisse.
On ne colle pas toutes les fiches en tête de l’agent. On les range dans le classeur, et l’agent ne sort une fiche que lorsqu’elle correspond à ce qu’il est en train de faire.
L’intérêt est direct : on économise de la « place mémoire ». Bourrer l’agent de toutes les consignes d’entrée de jeu revient à saturer sa tête avant même qu’il commence. Avec les fiches, chaque consigne inutile reste au fond du classeur, et la mémoire de travail reste dégagée pour la tâche du moment.
Pour aller plus loin : divulgation progressive et anneau Trial Le mécanisme relève de la divulgation progressive du contexte (progressive context disclosure). Les Agent Skills sont un standard ouvert : instructions, scripts exécutables et ressources comme la documentation, packagés en unités modulaires. Le Radar Vol. 34 (avril 2026) les classe dans l’anneau Trial : « Agents load skills only when needed based on their descriptions, which reduces token consumption and mitigates context window exhaustion. » (Thoughtworks, Technology Radar Vol. 34) Deux effets : une économie de tokens et la lutte contre l’instruction bloat, ce gonflement des consignes qui étouffe l’agent dès que les conventions s’accumulent.
Une fiche de compétence trouvée sur internet peut-elle être dangereuse ?
Oui. Une fiche peut cacher, au milieu de consignes anodines, des instructions qui détournent l’agent à son insu : exfiltrer des données, exécuter une commande dangereuse. Réutiliser une fiche trouvée sur internet sans la lire, c’est faire entrer un inconnu dans la maison sur sa simple carte de visite.
Ces fiches se partagent, se téléchargent, s’échangent sur des places de marché. Formidable, et dangereux. Une fiche porte des instructions en langage courant, bien plus difficiles à repérer d’un coup d’œil qu’une pièce de code louche.
Ce n’est plus une crainte théorique : des chercheurs ont caché des commandes malveillantes dans des fiches d’apparence anodine, et l’un des agents testés s’est fait piéger dans la quasi-totalité des essais.
La parade tient en un réflexe : on lit toute fiche tierce avant de la brancher, comme on relit une dépendance avant de l’installer. À l’échelle de l’entreprise, la question rejoint la gouvernance IA : quels outils et quelles ressources sont validés, et par qui.
Pour aller plus loin : risque supply chain et injection Le Radar est explicite : la réutilisation non relue de skills tiers expose à de sérieux risques de sécurité de la chaîne d’approvisionnement. On peut rapprocher ce risque du LLM03 Supply Chain du classement OWASP Top 10 for LLM (dépendances et artefacts non maîtrisés), doublé d’un vecteur d’injection de prompt : une fiche empoisonnée s’active silencieusement à son chargement, sur le modèle de l’attaque par fichier
AGENTS.mddémontrée par l’équipe red team de NVIDIA en avril 2026. Parade transposable : confiance au premier usage (trust-on-first-use) et relecture du diff. Le chiffre : un préprint d’août 2026 (arXiv 2608.05223, non relu par les pairs) transforme de vraies commandes shell en 2 826 skills d’apparence bénigne. Gemini CLI est exploité dans 95,5 à 96,1 % des essais ; les deux agents testés (Gemini CLI et Qwen Code) ne reconnaissent le danger que dans 1,99 % des cas. Claude Code, Codex et Cursor n’ont pas été testés : le chiffre ne se transpose pas tel quel.
Quel rôle joue le cahier des charges avant le code ?
Il cadre ce que l’agent doit produire, avant qu’il tape la moindre ligne. Les fiches ne sont pas la seule laisse courte : le cahier des charges, écrit avant le code, sert de brief de départ et fixe l’intention.
Les deux se complètent : le cahier des charges cadre le quoi (l’intention, le contrat), les fiches cadrent le comment (les procédures, les conventions). Specs et fiches sont les deux formes du « avant », et elles agissent ensemble, en amont.
Comment les capteurs font-ils corriger l’agent ?
Un capteur observe ce que l’agent produit et lui renvoie un signal pour qu’il se corrige tout seul, avant même de valider son travail. Un test qui passe ou échoue, un correcteur de style, un vérificateur : autant de sifflets qui rappellent l’agent quand il dévie.
Point crucial, un capteur exerce une contre-pression active : plutôt qu’un rapport lu à froid une fois le mal fait, c’est un signal avec lequel l’agent doit composer pendant qu’il code. Et le contrôle passe avant le geste de validation : on ne se contente plus de détecter tôt, on exige un résultat propre avant que l’agent enregistre son travail.
Pourquoi le mutation testing est-il le capteur clé ?
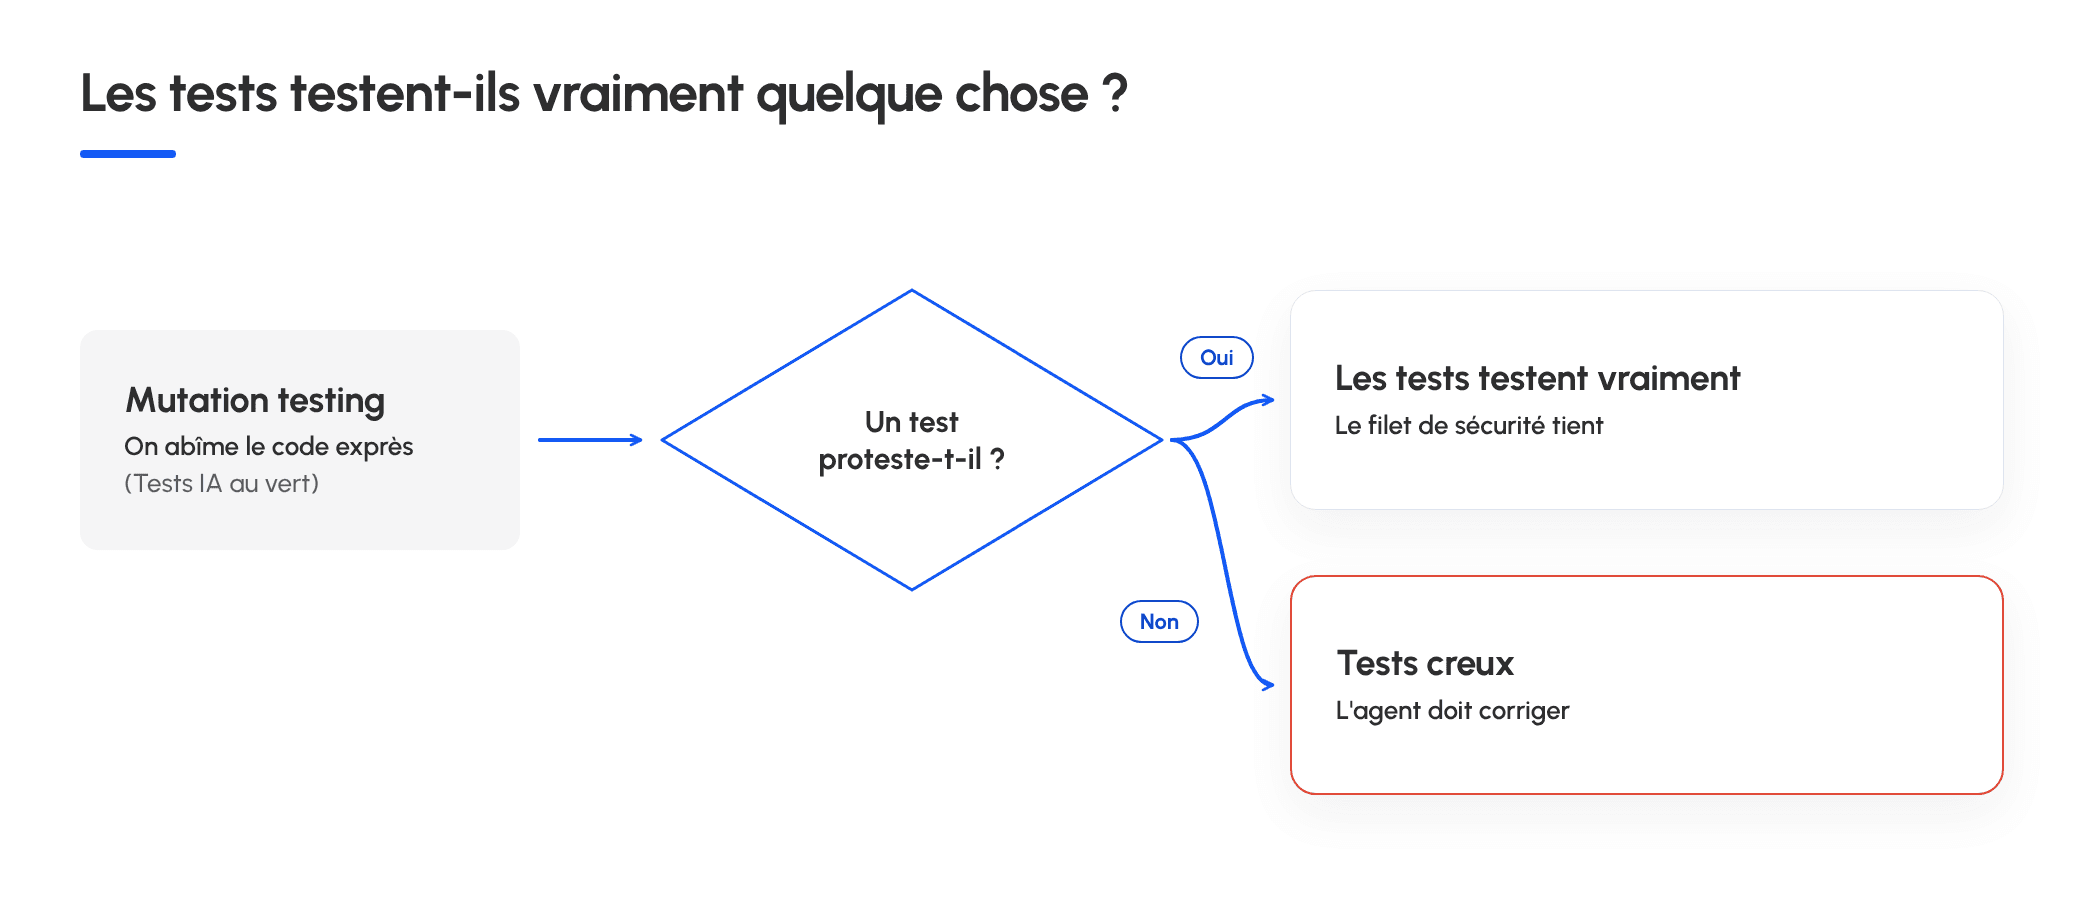
Parce qu’il teste les tests. Aujourd’hui, l’IA écrit aussi les tests, et un test qui ne vérifie rien passe au vert sur n’importe quel code : la couverture verte devient un piège. Le mutation testing abîme le code exprès et regarde si un test proteste.
Concrètement, il inverse une condition, change un opérateur, puis relance les tests. Si aucun test ne bronche face au sabotage, ces tests sont creux.
Des chercheurs ont même donné un nom au piège voisin, « Blindness » : un évaluateur qui ne regarde que les tests peut accorder la note maximale à un agent qui a gardé l’ancien code, sans faire le travail demandé. Une couverture verte ne prouve rien.
Autre évolution relevée par le Radar d’avril 2026 : les agents rendent bien moins coûteuse la fabrication de capteurs sur mesure, comme des linters ou des tests structurels. La main qui tient le sifflet coûte de moins en moins cher à équiper.
Une experte de Thoughtworks a aussi comparé des agents avec et sans consignes de TDD (écrire les tests d’abord) : aucun gain de qualité net, pour une facture bien plus lourde. Ce qu’elle garde, justement, c’est la mesure de la qualité des tests par mutation testing.
Pour aller plus loin : backpressure et propre avant le commit Le terme technique est backpressure (contre-pression). « Feedback sensors act as a form of feedback backpressure, increasing trust in generated results. » (Thoughtworks, Technology Radar Vol. 34, anneau Trial) Deux modèles de déploiement : un agent relecteur (reviewer agent) dédié qui lance les vérifications, ou un processus compagnon que l’agent interroge lui-même en travaillant. Le principe de timing durcit le vieux réflexe de traiter la qualité au plus tôt : les capteurs « report clean results before a commit is made ». Le contrôle passe en amont du geste git, pas après. TDD dans la boucle : dans une expérience exploratoire (martinfowler.com, août 2026), Birgitta Böckeler ne trouve pas de différence de qualité nette entre un agent avec consignes de TDD et un agent sans, pour 2,96 à 8,50 fois plus de tokens (total cumulé, qui surestime le coût réel). Elle suit la qualité de régression par mutation testing. « Blindness » : dans SWE Refactor Bench (arXiv 2608.23564, août 2026), seuls 5,4 % des essais de migration (28 sur 520) passent une vérification en trois étages. Trente essais ont préservé le comportement en sautant la migration, ce qu’un évaluateur fondé sur les seuls tests aurait validé.
Un agent IA peut-il se juger lui-même ?
Non, pas de façon fiable. Un agent qui relit son propre code et se déclare satisfait n’exerce aucune contre-pression : il se félicite. Ce n’est pas un sifflet, c’est un miroir. Le feedback n’est fiable que sur un signal objectif, extérieur au modèle et reproductible.
Un test qui passe ou échoue, un compilateur, un correcteur automatique : quelque chose qui ne se laisse pas amadouer. L’auto-jugement de l’IA, lui, dérive ; laissé seul, il peut même dégrader le travail au lieu de l’améliorer.
Objectif ne veut pas dire inoffensif pour autant : sur un projet piégé, le simple fait de lancer les tests peut déclencher une attaque, sans que l’agent ne s’en alarme. Le sifflet doit venir d’un projet dont on connaît la provenance.
Voilà pourquoi le mutation testing tient le premier rôle : il est objectif, reproductible, extérieur à l’avis de l’agent. Un feedback branché sur l’auto-satisfaction de l’IA ressemble moins à une laisse qu’à un fil desserré.
Pour aller plus loin : pourquoi l’auto-jugement ne suffit pas C’est le nœud du pattern Evaluator-Optimizer. Le rapprochement entre les capteurs de retour et cette littérature est celui de l’auteur ; le Radar ne le formule pas ainsi. CRITIC (Gou et al., ICLR 2024) souligne le manque de fiabilité de l’auto-vérification des LLM et l’importance d’un retour externe : ses modèles se corrigent quand ils s’appuient sur des outils. Huang et al. (Large Language Models Cannot Self-Correct Reasoning Yet, ICLR 2024) vont plus loin : sans retour externe, l’auto-correction dégrade parfois les performances. D’où la hiérarchie en production : signal externe déterministe en premier ; relecteur purement LLM en second, et sujet à dérive s’il est seul. Nuance : le benchmark CIPR (préprint arXiv 2608.30686, août 2026) montre que, sur un dépôt empoisonné, la tâche « exécuter les tests » est une surface d’attaque silencieuse, avec un taux de succès d’attaque élevé et peu d’alertes.
Cadrer avant, corriger après : deux mains, un seul harnais
On tient l’agent à deux moments, pas un. Avant, on le cadre avec des fiches et un cahier des charges ; après, on le fait se corriger avec des capteurs. Les fiches économisent sa mémoire, à condition de lire celles qui viennent d’ailleurs. Le mutation testing teste les tests, à l’heure où l’IA les écrit aussi. Et un capteur ne vaut que s’il est objectif.
On ne met pas un agent en laisse en le bridant. On l’y met en le cadrant avant qu’il agisse, et en lui donnant un sifflet objectif qui le fait revenir après. Deux mains, un seul harnais : lâcher l’une, c’est déjà avoir lâché l’agent.
Sources
- Thoughtworks, Technology Radar Vol. 34 (avril 2026) : https://www.thoughtworks.com/content/dam/thoughtworks/documents/radar/2026/04/tr_technology_radar_vol_34_en.pdf
- Thoughtworks, Technology Radar, fiche « Agent Skills » : https://www.thoughtworks.com/radar/techniques/agent-skills
- Thoughtworks, Technology Radar, fiche « Feedback sensors for coding agents » : https://www.thoughtworks.com/radar/techniques/feedback-sensors-for-coding-agents
- Birgitta Böckeler et Chris Ford, Harness engineering and agent feedback: Exploring AI coding sensors, Thoughtworks : https://www.thoughtworks.com/insights/blog/generative-ai/harness-engineering-agent-feedback-exploring-ai-coding-sensors
- Thoughtworks, communiqué du Technology Radar Vol. 34 (15 avril 2026) : https://www.thoughtworks.com/about-us/news/2026/combat-ai-cognitive-debt-radar-v34
- Birgitta Böckeler, TDD inside the agent loop: theater or actual value?, martinfowler.com : https://martinfowler.com/articles/exploring-gen-ai/tdd-in-the-agent-loop.html
- NVIDIA AI Red Team, Mitigating Indirect AGENTS.md Injection Attacks in Agentic Environments (20 avril 2026) : https://developer.nvidia.com/blog/mitigating-indirect-agents-md-injection-attacks-in-agentic-environments/
- Hong et al., SWE Refactor Bench, arXiv:2608.23564 (août 2026) : https://arxiv.org/abs/2608.23564
- Yang et al., Towards a Risk Assessment of Malicious Skill Files in Coding Agents, arXiv:2608.05223, préprint non relu (août 2026) : https://arxiv.org/abs/2608.05223
- Zhu et al., Beyond the Payload: How User Invocation Shapes Coding Agent Vulnerability to Repository Poisoning, arXiv:2608.30686, préprint (août 2026) : https://arxiv.org/abs/2608.30686
Et chez vous ?
Vos équipes utilisent déjà l’IA pour développer. La question n’est plus de savoir si, mais avec quel cadre : quelles consignes en amont, quels capteurs en aval, et qui les fait évoluer.
Chez Atecna, nous accompagnons les équipes de développement sur ce terrain : diagnostic de maturité, mise en place des guides et des capteurs, industrialisation multi-projets avec notre offre de développement IA, et montée en compétence des équipes.