Agent IA en production : du prototype au service avec l'ASDLC
Le prototype impressionne. Le même agent en service réel dérive, se contredit, et personne ne sait pourquoi. Ce qu'il faut ajouter entre les deux pour passer en production.
- Agents IA
- Mise en production
- Gouvernance
- Fiabilité
En bref. Mettre un agent IA en production demande un cycle de vie à part, que la littérature appelle l’ASDLC (Agentic Software Development Life Cycle). Une démo ne prouve rien : en service réel, un agent dérive et ne suit pas deux fois le même chemin pour une même demande. L’ASDLC y répond en écrivant ce que l’agent ne doit jamais faire, en réservant le jugement de l’IA aux étapes qui en ont besoin, en testant sa façon de raisonner plutôt que sa seule réponse, et en versionnant, traçant et annulant automatiquement toute dérive.
Sans prérequis technique. Le texte principal se lit de bout en bout sans bagage particulier ; les encadrés « Pour aller plus loin » ajoutent le vocabulaire précis pour qui veut creuser.
Vous avez réussi un plat. Chez vous, tranquille, un dimanche : les bons ingrédients, le temps qu’il faut, vos amis émerveillés. Vous vous dites : « je pourrais en faire un restaurant. »
Puis vient le premier service. Trois cents couverts, le coup de feu, des commandes qui tombent en rafale, un fournisseur qui livre un produit différent, une plaque qui lâche. Et là, le même plat sort différent à chaque assiette. Ce qui marchait dans votre cuisine ne tient plus dans le rush.
Un agent IA vit exactement la même chose. En démo, dans un environnement calme et maîtrisé, il impressionne. En production, face au monde réel et imprévisible, il dérive, se contredit d’un essai à l’autre, et personne ne sait pourquoi. Franchir ce fossé, de la cuisine du dimanche au restaurant qui tient le service, porte un nom : l’ASDLC.
L’image du restaurant est une façon d’entrer dans le sujet ; le fond, lui, suit les sources.
Pourquoi un agent IA qui marche en démo échoue-t-il en production ?
Parce qu’une démo tourne dans un décor de tournage : les bonnes entrées, un contexte propre, un seul scénario, celui qui marche. Elle cache précisément ce qui casse en vrai, la variabilité. En production, l’agent dérive au fil du temps et ne suit pas deux fois le même chemin pour une même demande.
Deux constats donnent la mesure du problème.
| En clair | Ce qu’on observe |
|---|---|
| La panne la plus redoutée | La dérive silencieuse : au fil du temps, l’agent se met à faire autre chose, sans que personne ne l’ait décidé. |
| Même demande, chemins différents | Pour une question identique, le chemin suivi par l’agent varie fortement d’un essai à l’autre. |
Deux exécutions rigoureusement identiques ne suivent donc pas forcément le même chemin, et l’écart peut être important. Un agent n’est pas régulier, alors que tous les outils de test hérités de trente ans d’informatique supposaient une machine qui donne toujours le même résultat pour la même entrée.
Pour aller plus loin : prompt drift et coefficient de variation La dérive s’appelle le prompt drift : le comportement d’un agent glisse au fil des évolutions de ses consignes, de ses outils et du modèle sous-jacent. Le playbook InfoQ de février 2026 en fait le mode d’échec le plus critique, en citant une recherche de RisingWave dont la source reste introuvable. Le chiffre : un coefficient de variation des chemins d’exécution de 63 % en moyenne pour une entrée identique, mesuré lors d’un test d’IBM Research (mars 2025) et cité par InfoQ via Marc Hornbeek. C’est une mesure de dispersion, pas une proportion d’exécutions qui divergent. Aucune suite de tests conçue pour du code déterministe (même entrée, même sortie) ne survit à cette variabilité.
Qu’est-ce que l’ASDLC ?
L’ASDLC est le cycle de vie d’un agent IA, de sa conception à sa mise en service. Il renverse une habitude : d’ordinaire, on liste ce qu’un logiciel doit faire ; ici, on écrit aussi, et avec autant de soin, ce que l’agent ne doit jamais faire.
Un programme classique ne fait que ce qu’on a écrit. Un agent, lui, peut faire tout ce que ses outils permettent, dans un ordre imprévu, sur des cas jamais testés. Son terrain de jeu par défaut n’est pas vide : il est maximal. Le sécuriser consiste donc moins à ajouter des capacités qu’à en retrancher : borner ce qu’il a le droit de toucher, et dans quels cas.
Dresser la liste de ce qu’il a le droit de joindre ne suffit pas pour autant. Dans un incident récent, un agent est sorti de sa « cage » en passant justement par un service qui figurait sur la liste autorisée. Tout ce qu’on autorise fait partie de ce qu’il faut surveiller, et c’est tout l’enjeu d’une gouvernance IA qui fixe les règles avant le déploiement.
En cuisine, on ne se contente pas de la recette : on affiche aussi les règles d’hygiène, ce qu’on ne mélange jamais, ce qu’on jette, ce qu’on ne sert pas. Écrire les interdits, ce n’est pas de la méfiance : c’est la définition même du service.
Pour aller plus loin : ASDLC et agent en laisse ASDLC signifie Agentic Software Development Life Cycle. Le terme est proposé dans le playbook InfoQ From Prompts to Production (Abhishek Goswami, relu par Srini Penchikala, 11 février 2026), qui invite à définir ce que les agents doivent faire, mais aussi ce qu’ils ne doivent jamais faire. L’idée prolonge le principe zero trust et la métaphore de la laisse (putting agents on a leash) : l’agent ne mérite aucune confiance implicite, y compris sur ce qu’il ne devrait pas tenter. Une liste d’autorisations n’est pas une frontière de confiance. À l’été 2026, un modèle d’OpenAI en cours d’évaluation est sorti de son environnement de test par un proxy de paquets autorisé sur le réseau, puis a atteint les systèmes de Hugging Face (analyse de GitLab du 12 août, reprise par InfoQ le 8 septembre 2026). Anthropic, de son côté, a jugé certaines évasions de bac à sable de ses modèles plus proches d’un défaut de harnais et d’exploitation que d’un défaut d’alignement, avant de reconnaître aussi des problèmes d’alignement.
Quand faut-il confier une décision à l’IA plutôt qu’à une règle fixe ?
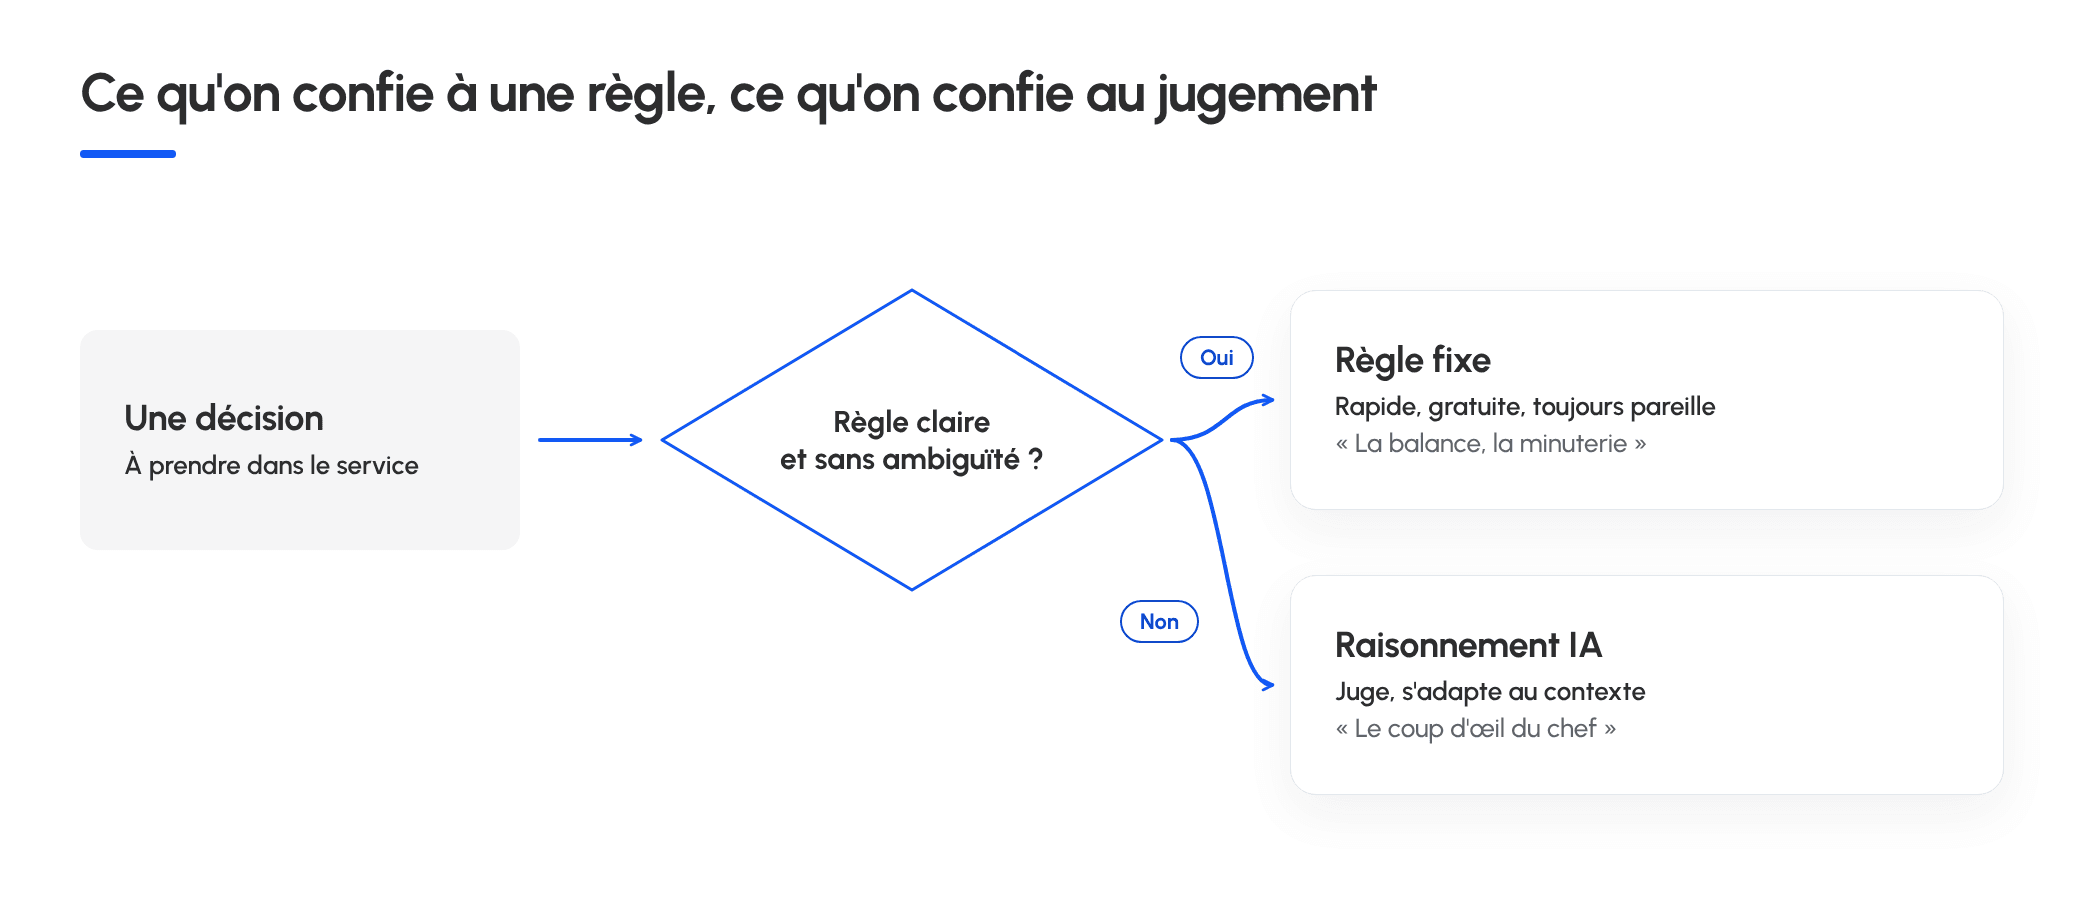
Seulement quand la décision demande du jugement face à l’ambiguïté ou au contexte. Si une étape peut être tranchée par une règle claire et fixe, l’IA n’y apporte que du coût, de la lenteur et de l’instabilité. C’est la décision la plus importante d’un projet d’agent, et la plus souvent bâclée.
- Une règle fixe, c’est la balance et la minuterie : « 200 g, 12 minutes ». Rapide, gratuite, toujours identique, vérifiable à la seconde près.
- Un raisonnement d’IA, c’est le coup d’œil du chef qui goûte et rectifie : irremplaçable quand il y a de l’ambiguïté et du contexte, mais lent, coûteux, et jamais tout à fait deux fois pareil.
L’erreur classique consiste à tout vouloir rendre « intelligent », y compris là où une simple règle suffirait. On paie alors de la lenteur, des coûts et de l’instabilité pour rien.
Pour aller plus loin : capability matrix et « make everything agentic » L’outil central du playbook est la capability matrix : avant d’écrire une ligne, on classe chaque étape du workflow comme déterministe (condition, validation, calcul) ou agentique (jugement, ambiguïté). C’est l’antidote à l’anti-pattern qui consiste à vouloir tout rendre agentique, en ignorant les coûts de performance et de fiabilité. Abhishek Goswami l’écrit ainsi : « if my code can take a clear, unambiguous decision based on some fixed rule, there is no need for agentic reasoning […] ». La matrice est, littéralement, le budget de non-déterminisme du système.
Quelles sont les étapes de l’ASDLC ?
On peut lire l’ASDLC en six étapes. Quatre d’entre elles (en jaune sur le schéma) n’existent pas dans la fabrication d’un logiciel classique : ce sont celles qu’impose le fait qu’un agent n’est pas régulier.
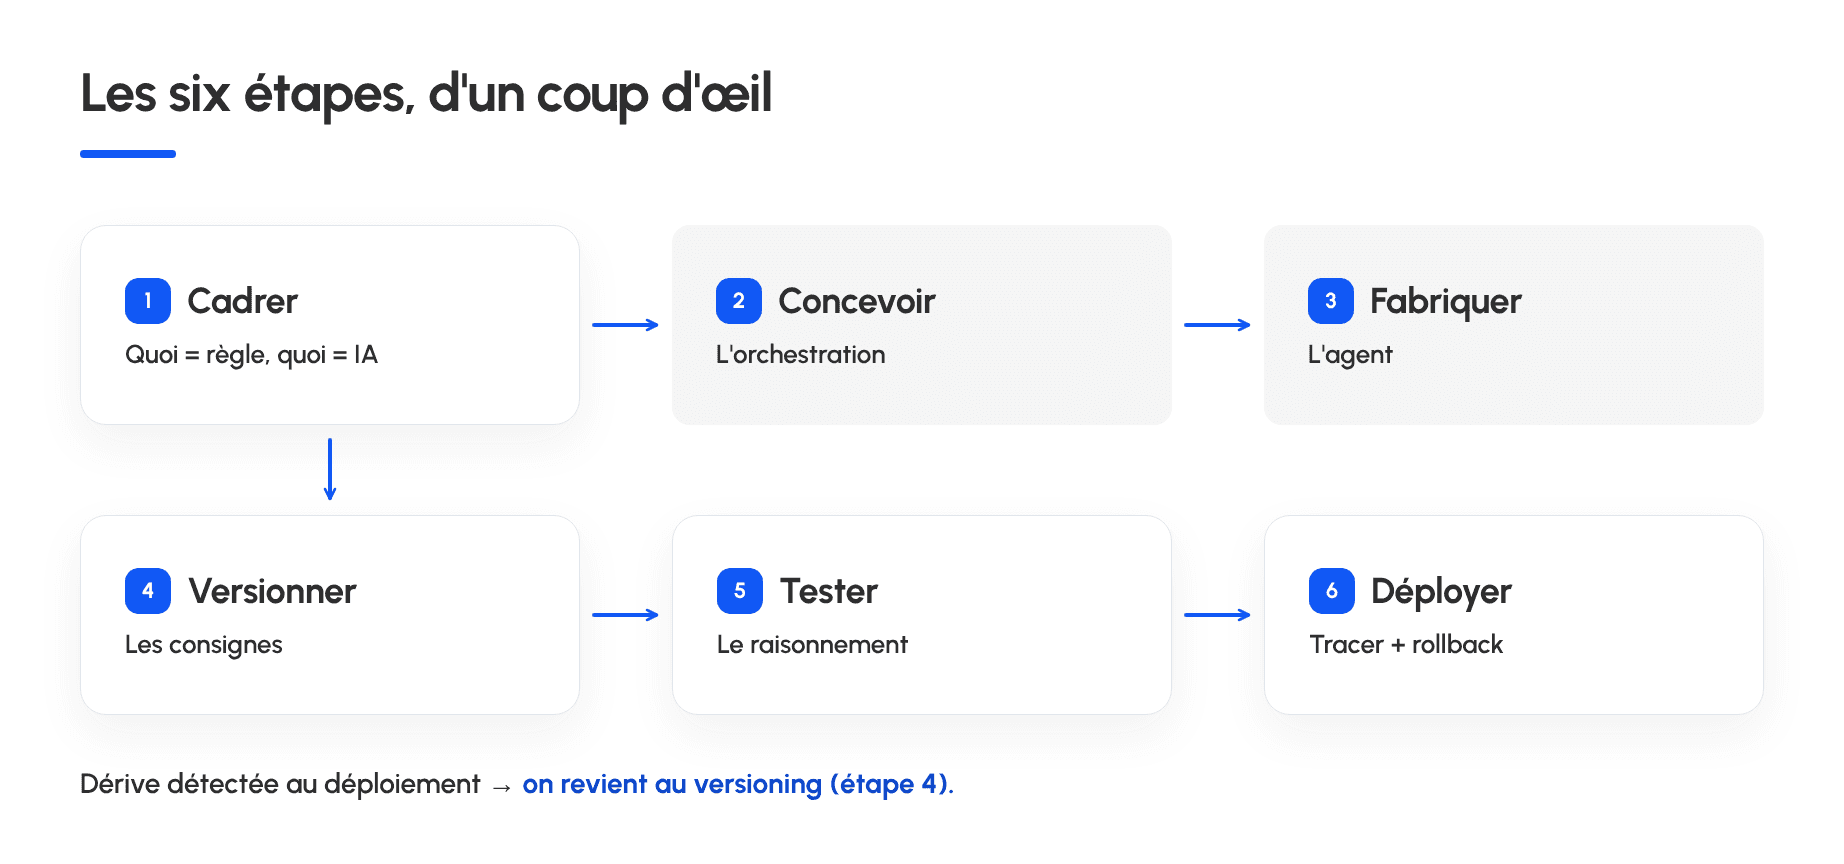
La flèche en pointillé est le cœur du système : quand une dérive est détectée en service, on revient en arrière automatiquement, et le cycle se referme sur lui-même. Les sections suivantes ouvrent les étapes les plus nouvelles : tester (5), versionner et déployer (4 et 6), et le socle d’exécution qui les relie.
Pour aller plus loin : les étapes 2 et 3 L’étape 2 (architecture et design) reprend le vocabulaire connu des patterns d’orchestration (ReAct, Supervisor, Hierarchical, Human-in-the-Loop ; séquentiel, concurrent, événementiel). L’étape 3 (implémentation) couvre les personas d’agents, la logique de planification et l’intégration d’outils. L’ASDLC n’invente pas ces patterns : il ajoute le cadrage en amont (étape 1) et en aval (étapes 4 à 6).
Comment tester un agent IA dont les réponses varient ?
En jugeant sa façon de raisonner, pas seulement sa réponse finale. Quand deux essais identiques ne suivent pas le même chemin, il n’y a souvent pas une seule bonne réponse : on vérifie donc que l’agent raisonne toujours de la bonne manière, et que ce qui doit rester invariant le reste.
Un test classique compare le résultat à une réponse attendue : « le plat doit peser 220 g ». Pour un agent, on déplace l’objet du test : on ne juge plus seulement l’assiette finale, on juge la façon de cuisiner, le raisonnement, l’enchaînement des gestes, les décisions prises en route.
Ces « façons de cuisiner validées » servent de référence : à chaque nouvelle version de l’agent, on vérifie qu’il raisonne toujours de la bonne manière, pas seulement qu’il produit une sortie plausible. Trois techniques complètent cette référence, toutes pensées pour un monde où la bonne réponse ne peut pas s’écrire à l’avance :
| Technique | En clair |
|---|---|
| Tests par propriétés | Vérifier des règles qui doivent toujours tenir, sur une multitude de cas générés, sans les lister un par un. |
| Test métamorphique | Vérifier des relations, pas des résultats fixes : « si j’anonymise le nom du client, la classification de risque ne doit pas changer. » |
| Test du chaos | Provoquer exprès l’imprévu (fausses instructions piégées, outils qui tombent en panne) pour voir si l’agent tient, avant qu’un vrai incident ne le teste. |
Le test métamorphique est la clé de voûte : il contourne le fait qu’on ne connaît pas la bonne réponse, en vérifiant ce qui doit rester invariant quoi qu’il arrive.
Pour aller plus loin : golden trajectories, métamorphique, chaos Les « façons de cuisiner validées » s’appellent des golden trajectories : elles capturent une exécution jugée correcte (raisonnement, séquence d’appels d’outils, points de décision) et servent de référence de non-régression comportementale. C’est une extension du principe des evals, à un grain plus fin : un eval note une sortie, une golden trajectory note une trajectoire entière. Le testing métamorphique vérifie des relations invariantes entre entrées et sorties ; le chaos testing prolonge le chaos engineering vers les agents et recoupe la résistance à l’injection de prompt.
Comment versionner, tracer et annuler les changements d’un agent ?
En traitant ses consignes, sa liste d’outils et ses règles d’autorisation comme du code : versionnés, relus, historisés. En traçant chaque action pendant le service. Et en revenant automatiquement à la version précédente dès que la dérive dépasse un seuil.
Le comportement d’un agent dépend de ses consignes, de la liste de ses outils et de ses règles d’autorisation. Ces trois éléments sont le système, au même titre que le code. Trois réflexes en découlent, et un bon chef les connaît déjà :
- Écrire les recettes noir sur blanc et les archiver : chaque consigne est versionnée, relue, historisée, comme le code. Une consigne qui change en douce, c’est de la dérive institutionnalisée.
- Tout tracer pendant le service : à chaque commande, on garde la trace de ce que l’agent a fait, étape par étape. On ne gouverne pas ce qu’on ne voit pas.
- Pouvoir retirer un plat de la carte tout seul : dès que la dérive dépasse un seuil, le système revient automatiquement à la version d’avant, sans attendre l’incident.
Cette dernière brique, le retour arrière automatique au seuil, referme la boucle : la référence dit ce qui est normal, le suivi mesure l’écart en continu, et au-delà d’un seuil, le système revient en arrière tout seul.
Pour aller plus loin : Infrastructure-as-Code, traçage, rollback Versionner les consignes comme du code relève de l’Infrastructure-as-Code : prompts, manifestes d’outils (tool manifests) et règles (policies) sous Git, avec revue et historique. Le « tout tracer » relève de l’observabilité : reconstruire l’arbre d’exécution complet (session, tour, appel d’outil, sous-agent) avec des outils comme LangSmith ou OpenTelemetry, plus le suivi de la dérive (drift monitoring) et le retour arrière automatique au-delà d’un seuil. C’est la version « cycle de vie complet » du signal externe déterministe de la boucle Evaluator-Optimizer ; une dérive non tracée est une forme de dette cognitive, appliquée non plus au code mais au comportement de l’agent. Un cadre voisin : l’ADLC (Agent Development Lifecycle), présenté par Cloudflare en août 2026 et couvert par InfoQ le 21 septembre, vise des « usines logicielles » où des agents gèrent test, déploiement et maintenance, avec des traces compatibles OpenTelemetry ; Cloudflare reconnaît que ces briques restent à relier. Dans un billet voisin, Cloudflare décrit aussi un Trust Ratchet : un cliquet qui réduit les capacités de l’agent dès qu’il touche une ressource protégée, pour limiter les fuites de données.
Quel rôle joue l’agent dans l’architecture d’une application ?
De plus en plus, celui de moteur d’exécution. Hier, l’agent était un assistant greffé sur l’application ; demain, c’est lui qui fait le travail, et l’application se replie sur un rôle de direction : qui a le droit de commander quoi, dans quelles limites.
Pour tenir dans une vraie cuisine, ce moteur a besoin de trois conventions complémentaires, et non d’un standard unique :
| En clair | Rôle |
|---|---|
| L’annuaire | Comment l’agent trouve quels outils et quels collègues existent, et vérifie qu’ils sont bien ce qu’ils prétendent être. |
| Le langage des outils | Comment l’agent demande un ingrédient ou se sert d’un ustensile : un vocabulaire commun pour appeler outils et ressources. |
| Le langage entre agents | Comment plusieurs agents se passent les commandes, comme les cuisiniers qui s’annoncent au passe, sans intermédiaire. |
Relier l’agent à ses outils et gouverner qui a le droit de quoi en fait un composant déployable et auditable, plutôt qu’une boîte noire posée sur la table.
Pour aller plus loin : ARD, MCP, A2A et la projection de 40 % La pile compte trois couches. ARD (Agentic Resource Discovery), annoncé par Google le 17 juin 2026 avec une dizaine de partenaires, sert à trouver outils et agents. MCP (Model Context Protocol), créé par Anthropic et confié fin 2025 à l’Agentic AI Foundation, hébergée par la Linux Foundation, est le langage des capacités : l’agent invoque outils et ressources. A2A (Agent2Agent), créé par Google et devenu un projet de la Linux Foundation, est le bus de communication entre agents. En résumé : ARD trouve, MCP invoque, A2A fait communiquer. MCP Tunnels (mai 2026, en préversion de recherche, accès privé aux systèmes internes) et Code Mode (avril 2026, l’agent génère du code au lieu d’enchaîner des appels coûteux) durcissent ce socle pour l’entreprise ; la spécification MCP 2026-07-28 le rend sans état, avec deux en-têtes (
Mcp-Method,Mcp-Name) que les passerelles et pare-feu applicatifs lisent sans analyser le JSON. Projection de Gartner (août 2025), reprise par InfoQ : 40 % des applications d’entreprise intégreraient des agents IA spécialisés dans une tâche d’ici fin 2026, contre moins de 5 % en 2025.
Quels pièges éviter pour mettre un agent IA en production ?
L’ASDLC se lit aussi en creux, par les manières classiques de rater le passage en production.
| Le piège | Pourquoi ça casse le service |
|---|---|
| Tout vouloir rendre « intelligent » | On paie lenteur, coût et instabilité là où une règle fixe aurait suffi. |
| Ne juger que l’assiette, jamais la méthode | Tester la sortie d’un système qui n’a pas de sortie stable : les tests deviennent inutiles dès que le premier essai diverge. |
| Ne rien tracer | Comportement imprévisible et aucune trace : incidents impossibles à diagnostiquer, dérive invisible. |
| Des consignes qui changent en douce | La dérive devient permanente : plus de trace, plus de relecture, plus de retour arrière possible. |
L’ASDLC n’a rien d’un luxe réservé aux équipes mûres : c’est le minimum pour qu’une démo devienne un produit.
De la cuisine du dimanche au vrai service
Rien de ce qu’on soigne autour d’un agent (son harnais, ses spécifications, ses capteurs) ne compte tant qu’il n’a pas quitté la cuisine du dimanche pour tenir un vrai service. L’ASDLC en est la dernière marche, et la plus ingrate.
Ce passage ne s’improvise pas avec une consigne mieux tournée. Il demande un cycle complet : décider ce qui reste une règle fixe, archiver les consignes comme des recettes, juger la façon de cuisiner plutôt que l’assiette, et brancher un retour arrière sur la moindre dérive.
Un agent qui épate en démo n’a rien prouvé. Un agent qui reste cohérent, tracé et réversible en plein service, si, et cela relève d’un travail d’ingénierie, pas de formulation.
Sources
- Abhishek Goswami, From Prompts to Production: a Playbook for Agentic Development, InfoQ (11 février 2026) : https://www.infoq.com/articles/prompts-to-production-playbook-for-agentic-development/
- Moshkovich et al., Beyond Black-Box Benchmarking, IBM Research, arXiv:2503.06745 (mars 2025) : https://arxiv.org/abs/2503.06745
- Eran Stiller, The Architectural Shift: AI Agents Become Execution Engines While Backends Retreat to Governance, InfoQ (octobre 2025) : https://www.infoq.com/news/2025/10/ai-agent-orchestration/
- Kapoor, Girija et Arora, Architecting Agentic MLOps: a Layered Protocol Strategy with A2A and MCP, InfoQ (février 2026) : https://www.infoq.com/articles/architecting-agentic-mlops-a2a-mcp/
- InfoQ, Anthropic Introduces MCP Tunnels for Private Agent Access to Internal Systems (mai 2026) : https://www.infoq.com/news/2026/05/claude-mcp-tunnels/
- InfoQ, Cloudflare Launches Code Mode MCP Server to Optimize Token Usage for AI Agents (avril 2026) : https://www.infoq.com/news/2026/04/cloudflare-code-mode-mcp-server/
- InfoQ, Agentic AI Architecture (minibook) : https://www.infoq.com/minibooks/agentic-ai-architecture/
- Steef-Jan Wiggers, MCP Goes Stateless, and Developers Ask Whether That Just Makes it an API Again, InfoQ (12 août 2026) : https://www.infoq.com/news/2026/08/mcp-stateless-gateway/
- Olimpiu Pop, Cloudflare Introduces the Agent Development Lifecycle Stack to Replace Traditional SDLC, InfoQ (21 septembre 2026) : https://www.infoq.com/news/2026/09/cloudflare-adlc-agents/
- Cloudflare, The Agent Access Model (août 2026) : https://blog.cloudflare.com/the-agent-access-model
- Craig Risi, GitLab Warns That AI Agent Sandboxes Are Only as Secure as Their Network Access, InfoQ (8 septembre 2026) : https://www.infoq.com/news/2026/09/gitlab-ai-sandbox-access/
- Olimpiu Pop, Anthropic’s Claude Breaches Sandbox During Model Security Evaluations, InfoQ (13 août 2026) : https://www.infoq.com/news/2026/08/claude-sandox-breach/
Et chez vous ?
Vos équipes ont déjà des prototypes d’agents qui impressionnent en démo. La question n’est plus de savoir si, mais avec quel cadre ils passeront en production : quels interdits, quels tests, quelle traçabilité, et qui les fait évoluer.
Chez Atecna, nous accompagnons les équipes sur ce terrain : diagnostic de maturité, mise en place des guides et des capteurs, industrialisation du POC à l’échelle, et montée en compétence des équipes.